 Techarm Blog
Jevは日本語で使えるのか。落ちるのは「データ」ではなく「質問文」だった
Jevというモデルを最初に見たのは、YouTubeでした。
https://www.youtube.com/watch?v=jaVeEz1yY4oそこから公式サイトに行って、Xのポストを読みました。TypeSafeという会社が出した「System One モデル」の1本目だそうです。
https://x.com/CompleteSkeptic/status/2099925682726002904ポストにはこう書いてあります。
- 20〜200倍速い
- 40〜400倍安い(出力トークンは無料)
- 判断に最適化された、合成可能なフロンティア知能
この倍率には素直に驚きました。そして、なぜそこまで違うのかが気になりました。
調べて納得しました。このモデルは文章を返しません。
返ってくるのは確率だけです。チャットもできないし、理由も説明しない。1トークンずつ順番に生成していく今までのLLMとは、処理のしかたがそもそも違います。だから速いし、だから安い。
倍率だけなら「またか」で終わったと思います。仕組みが違うと分かったところで、一気に興味が湧きました。
waitlistに登録したのが9月18日の夜8時。
順番待ちが回ってきたのは、翌朝8時42分でした。半日ちょっとです。
ここからアカウントを作って、APIキーを発行しました。
叩いてみて、速さと安さは体感としてそのとおりでした。
ここが自分には大事なところです。
もし今までのLLMと同じ速さ、同じ値段だったら。仕組みがどれだけ新しくても、使い道は限られたと思います。
速くて安いからこそ、これまで無理だった使い方ができる。そこに期待しています。
ただ、「速かった」という体感はそのままでは何の根拠にもなりません。公式が出している数字も、西海岸から自分たちで測ったものです。
日本から使ったら実際どれくらいなのか。日本語は通るのか。誰も書いていなかったので、数字で測りました。
先に結論
1. 大阪から p50 238ms。 公式が言う70〜500msの範囲内ですが、遅い側です。
2. 質問を1個にしても27個まとめても、速度は変わりません。 公式が言っているとおりでした。
3. 日本語は問題ありませんでした。ただし条件があります。
3つ目が本題です。公式ドキュメントには「日本語を含むCJKは精度が落ちる」と書いてあります。ところが実際に測ると、落ちるのはデータの言語ではありませんでした。
ここだけ先に用語を決めさせてください。Jevに渡すものは2つに分かれます。
- 判定されるデータ — 分類したい問い合わせ文そのもの。APIでは
stateと呼びます - 質問文と選択肢 — 「これは何についての問い合わせか」「billingとは何か」という聞き方の定義。APIでは
instructionsとcriteriaです
この2つは別々に言語を選べます。公式ドキュメントはどちらのことを言っているのか書いていないので、分けて測りました。
どちらの条件でも、データのほうは英語版と日本語版の両方を試しています。それでも差が出たのは質問文の言語のほうでした。
つまり実務ではこうなります。
"質問文と選択肢は英語で書く。判定されるデータは日本語のままでいい。
次の章でモデルの仕組みを説明してから、そこに至るまでを順番に書きます。
Jevは何をするモデルか
深追いはしません。測るために必要な分だけ。
LLMに判断させるときは、テキストを投げて、返ってきた文字列をパースします。Jevは違います。
こちらが渡すのは2つだけです。
状態(state) — 判断してほしい材料。問い合わせ文でも、アプリの現在の状態でもいい。
型のついた質問 — 答えの形をこちらが先に決めます。聞き方そのものが instructions、選択肢の定義が criteria です。型は3種類あります。
| 種類 | 聞けること | 返ってくるもの |
|---|---|---|
Choice | 選択肢から1つ選ぶ | 選択・各選択肢の確率・confidence |
Score | 段階で評価する | スコア・各段階の確率・confidence |
Noul | この文は真か | 0〜1の値 |
コードで書くとこれだけです。
from typesafe_sdk import Choice, TypeSafeClient
with TypeSafeClient() as client:
r = client.system_one(
state={"ticket": "注文A-104で二重に請求されています。返金してください。"},
questions={
"department": Choice(
instructions={"question": "Which team should handle this ticket?"},
criteria={
"billing": "Charges, invoices, payment problems",
"shipping": "Delivery status, delays, lost packages",
"other": "Fits none of the above",
},
)
},
)
print(r.answers["department"].choice) # billing
print(r.answers["department"].confidence) # 1.0JSONのパース処理もリトライも書いていません。答えの形は先に決まっているので、崩れようがないからです。
速いのは、トークンを1つずつ予測していないからです。文章を捨てたことと速いことが、同じ理由から来ています。
動作確認環境
- typesafe-sdk 0.7.0 / モデル
jev-1.13.0 - 計測地: 大阪(公式ベンチは「西海岸にある自分たちのノートPCから」と公式ブログに明記あり)
- 計測日: 2026年9月19日
公式が出している数字
自分で測る前に、公式が何を主張しているかを置いておきます。
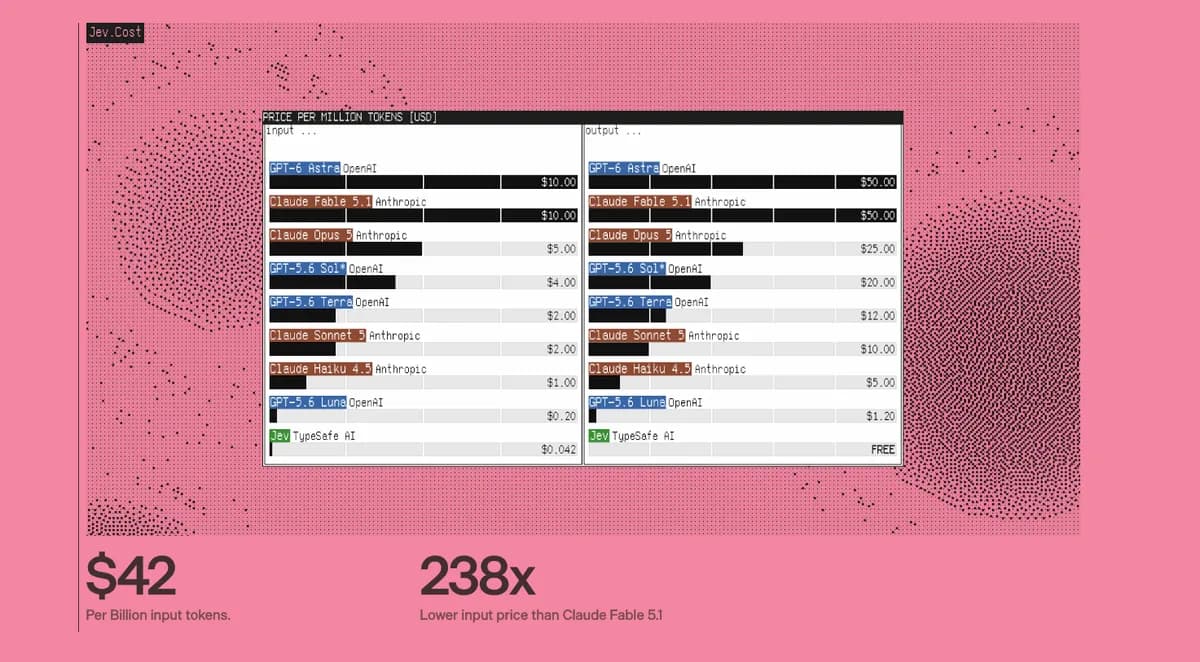
出典: TypeSafe AI 公式
入力 $0.042 / 100万トークン、出力は無料。Claude Fable 5.1 の入力単価の238分の1だと書かれています。
速度のデモも公開されています。同じ約27個の質問を、Jevと GPT-5.6 Terra に同時に投げた比較です。
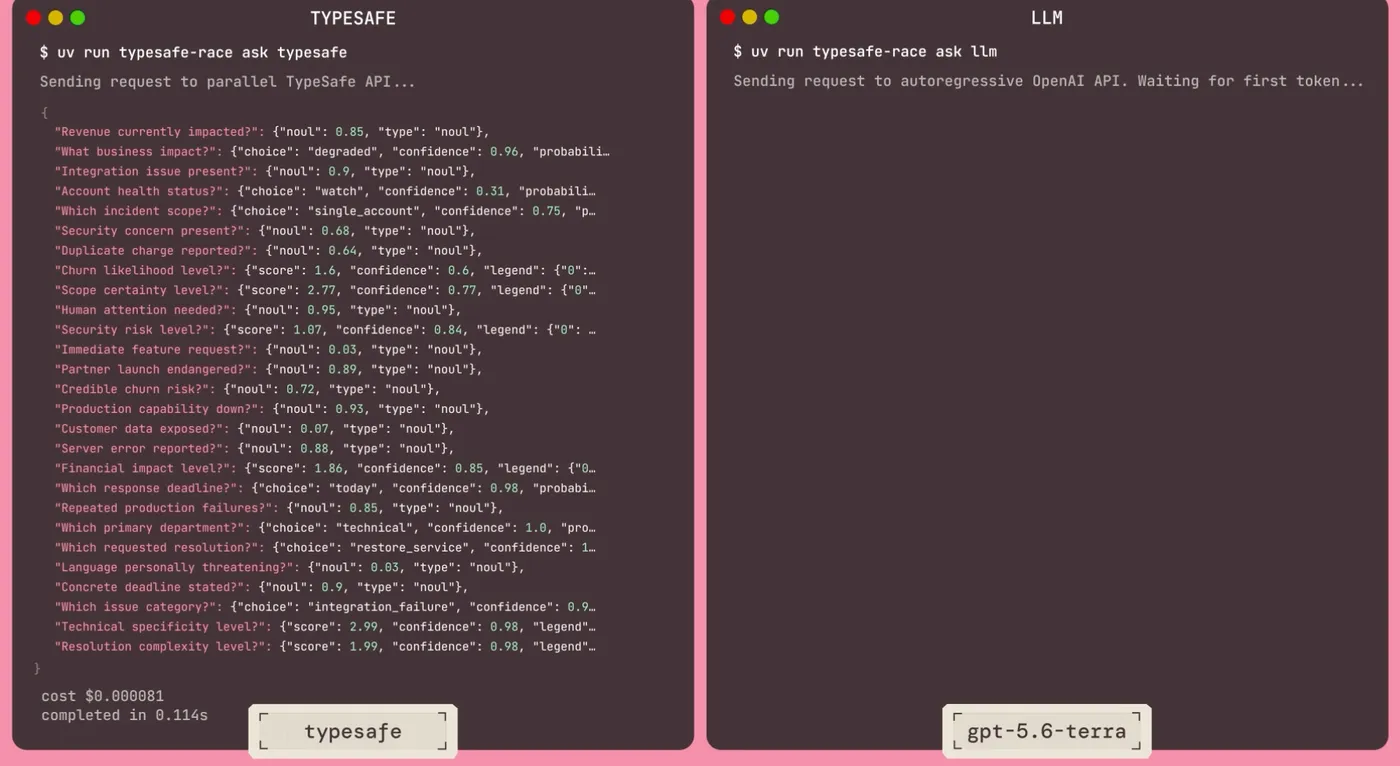
出典: TypeSafe AI 公式デモ(typesafe-race)
左はもう終わっています。0.114秒、$0.000081。 右はまだ1トークンも返ってきていません。
GPT-5.6 Terra 側の完走は 8.566秒でした(The Register が報じた数字です)。75倍。
コストのほうは上の価格表から計算できます。入力単価で $2.00 対 $0.042、およそ48倍。加えて Terra は出力にも $12.00/MTok かかりますが、Jevの出力は無料です。
派手な数字ですが、この読み方は後で書きます。まず自分で測ります。
公式ブログのほうには「40〜200倍速い」と書かれていて、Xのポストの「20〜200倍」と食い違います。
どちらを引くかで印象が変わるので、この記事では出典を明記して使っています。
測定1:大阪からどれくらいか
条件を4つに分けて、各40回ずつ。計160回です。
| 条件 | min | p50 | p95 | max |
|---|---|---|---|---|
| state=英語 / 質問1つ | 201 | 238 | 313 | 533 |
| state=英語 / 質問3つ同時 | 206 | 238 | 350 | 637 |
| state=日本語 / 質問1つ | 190 | 238 | 312 | 357 |
| state=日本語 / 質問3つ同時 | 193 | 234 | 301 | 313 |
4条件とも p50 は 234〜238ms。質問の数を増やしても、state を日本語にしても、速度は動きませんでした。
ひとつだけ別枠があります。接続していない状態からの1発目は 642ms かかりました。TLSハンドシェイクぶんです。2発目以降は上の表のとおり安定します。
公式の主張は70〜500ms。範囲には入っていますが、明らかに遅い側です。
これは責めるところではないと思っています。公式ブログ自身が書いています。ベンチは「西海岸にある自分たちのノートPCから」実行したものだ、と。大阪と西海岸の往復ぶんが乗っている、と考えれば辻褄は合います。
逆に言うと、公式の数字をそのまま日本の応答時間として読むと外します。
測定2:質問を増やすと遅くなるか
公式ドキュメントにこう書いてあります。
"Questions are evaluated in parallel. Adding questions barely changes the response time. (質問は並列に評価される。質問を増やしても応答時間はほとんど変わらない)
測定1で3問までは確かめました。公式デモと同じ27問まで伸ばします。1条件15回ずつ。
こちらは測定1とは別の問い合わせ文で測っているので、1問のときの基準値が249msになります。 見てほしいのは絶対値ではなく、質問を増やしたときの比です。
| 質問数 | p50 | 1問との比 | 入力トークン |
|---|---|---|---|
| 1 | 249ms | 1.00倍 | 342 |
| 3 | 252ms | 1.01倍 | 400 |
| 9 | 260ms | 1.05倍 | 574 |
| 18 | 231ms | 0.93倍 | 984 |
| 27 | 259ms | 1.04倍 | 1,717 |
27倍の質問を投げて、時間は1.04倍。 要するに平らです。
トークンは5倍に増えるので課金は増えます。増えないのは時間のほうです。
▶だから公式デモは速い
ここで最初の「0.114秒 対 8.566秒」に戻ります。あれは質問を約27個まとめた条件でした。
これはJevに最も有利な設定です。
LLM側は27問ぶんの答えを1トークンずつ生成します。質問を増やせば、その分だけ素直に遅くなる。質問が1個だけなら、8.5秒もかかりません。
つまり75倍という数字は、質問をまとめたときにだけ出る差です。
ただ、だから誇大だとは言えません。上の表のとおり、Jevが平らなのは本物です。差が開くのは、LLM側が線形に伸びるから。Jev側が特別な条件で速くなっているわけではありません。
"判断を1つだけ聞く用途なら、差はここまで開かない。 一度にたくさん聞く用途ほど、Jevが効く。
▶Vercelの計測がちょうどそれを裏付けていた
書いている途中で見つけました。Vercelのエンジニアが、自社の安全性チェック用の分類器を Jev に置き換えて測っています。
https://x.com/fazxes/status/210030009769523216470件のラベル付きケース × 3回 = 210判断。
| Jev | gpt-5.6-luna(置き換え前) | |
|---|---|---|
| 正解率 | 98.6% | 96.7% |
| 中央値 | 312ms | 1,458ms |
| p95 | 374ms | 6,583ms |
中央値で4.7倍、p95で17.6倍。
公式デモの75倍と比べると、だいぶ地味です。ただし、この2つを並べるときは注意が要ります。
| 比較相手 | 相手の入力単価 | 質問の投げ方 | 差 | |
|---|---|---|---|---|
| 公式デモ | GPT-5.6 Terra | $2.00 / MTok | 27問まとめて | 75倍 |
| Vercel | gpt-5.6-luna | $0.20 / MTok | 分類1つ | 4.7倍 |
比較相手のモデルが違います。 Luna は Terra の10分の1の単価の軽量モデルです。
つまり 75倍 → 4.7倍 の縮みは、「質問をまとめていないから」だけでは説明できません。相手が変わったぶんも混ざっています。
とはいえ、どちらの要因も同じ方向を向いています。質問を1つずつ投げて、相手が軽量モデルなら、差は一桁台に落ち着く。実務で置き換えを検討するときは、75倍ではなくこちらの水準で考えたほうが安全です。
なお、自分が大阪で測った238msと、この312msは近い水準でした。まったく別の環境・別のワークロードで同じくらいの数字が出ているのは、心強い材料です。
ただしこのベンチは手法が公開されていません。ラベルを誰がどう付けたかも書かれていません。
Vercel は Jev を AI Gateway に載せた側なので、利害関係もあります。
測定3:日本語は通るか
ここが本題です。
公式ドキュメントの State のページに、こう書いてあります。
"Jev's primary training language is English; other languages, including CJK scripts, are accepted but currently have lower accuracy. (主要な訓練言語は英語。CJKを含む他の言語も受け付けるが、現状では精度が落ちる)
Models のページには、もう少し踏み込んだ記述があります。
"test on your own content before relying on Jev for a non-English workload (英語以外で使うなら、頼る前に自分のコンテンツで試すこと)
「自分で試せ」と書いてある。つまりこの記事は、公式に言われたとおりのことをやっています。
どちらのページも「落ちる」としか書いていません。どれくらい落ちるのかは書いていない。
▶測り方
正解ラベルは用意しませんでした。自分のつけたラベルが正しいか、という別の議論になるからです。
代わりに一致するかどうかを見ました。
同じ内容の問い合わせを、英語版と日本語版で16対つくります。
"I was charged twice for order A-104. Please refund the duplicate."
「注文A-104で二重に請求されています。重複分を返金してください。」内容は同じで、違うのは言語だけ。これにまったく同じ質問を投げます。
食い違えば、内容ではなく言語が結果を動かしたことになります。各2回ずつ、計32組。
▶結果1:データが日本語でも、まったく落ちなかった
質問文を英語で固定して、state だけ英語と日本語で振ったときの結果です。
| 指標 | 結果 |
|---|---|
| Choice(種類)の一致 | 32/32(100%) |
| Score(緊急度)の差 中央値 | 0.095(0〜3のスケール) |
| Noul(詐欺判定)の差 中央値 | 0.010 |
1件も食い違いませんでした。 緊急度のズレも0〜3のスケールで0.095なので、誤差の範囲です。
confidence にいたっては日本語のほうが高い(0.958 対 0.910)。
「精度が落ちる」と書いてあったのに、落ちていません。
▶結果2:質問文を日本語にしたら落ちた
ここで気づきました。上の実験では、質問文と選択肢をずっと英語で書いていました。変えていたのは state の言語だけです。
公式が言う「他の言語」は、state のことなのか、質問文のことなのか。分けて測っていませんでした。
そこで質問文と選択肢も日本語にして、同じことをやります。
# 英語版
criteria={"billing": "An invoice, a payment, a charge, or a refund", ...}
# 日本語版
criteria={"billing": "請求、支払い、課金、返金", ...}| 質問文の言語 | Choice一致 | 入力トークン平均 |
|---|---|---|
| 英語 | 32/32(100%) | 575 |
| 日本語 | 28/32(88%) | 644 |
落ちました。 これが「問題」の正体です。
食い違ったのはこの2件でした。2回とも同じように食い違ったので、偶然ではありません。
| 問い合わせ | state英語 | state日本語 |
|---|---|---|
| 靴のサイズが違う。交換したい | other | shipping |
| パスワードを返信して確認してください | other | incident |
1件目は shipping の説明に「誤品や破損」が入っています。そちらが妥当です。つまり英語のstateのほうが外しています。
質問文を日本語にした瞬間、英語のデータに対する判定まで不安定になりました。
そして日本語の質問文は入力トークンが約12%増えます。遅くはなりませんが、その分の課金は乗ります。
▶だから、こうすればいい
質問文と選択肢は英語で書く。判定されるデータは日本語のままでいい。
日本語の問い合わせを分類したいなら、本文はそのまま日本語で渡します。英語で書くのは instructions と criteria だけ。
これで精度は英語と変わらず、トークンも少なくて済みます。
公式ドキュメントの例も、SDKのサンプルも、質問は全部英語です。従っておけば踏まない穴でした。
ただ「CJKは精度が落ちる」の一文だけ読むと、データを日本語で渡すのが危ないように読めます。そこが逆でした。
公式が自分で書いている「苦手なこと」
ドキュメントを読んでいて見つけました。jev-1.13 の弱点だけを並べたページがあります。
| 苦手なこと | 公式の対処法 |
|---|---|
| 書いてある文字どおりに読む | 条件を正確に書く |
| 計算・カウント | 算術はコードでやる |
| 日付・時刻の比較 | 要素を取り出させて、比較はコードで |
| 間接参照(二重否定など) | 直接書く |
| 無関係な情報が多い大きな state | 先に絞って送る |
| 敵対的な入力 | state は敵とみなされない。事前にテストする |
| instructions と criteria の食い違い | 両者を揃える |
| 構造的な一貫性の仮定 | 同一性はコードで担保する |
| 文章の生成 | 生成モデルを使う |
自分のモデルの弱点を9つ並べて公開しているのは、なかなか誠実だと思います。
そして1番目に、こう書いてあります。
"書いたとおりの質問に答える。意図した質問にではない。 間違った答えを見て「本当はこう言いたかった」と説明したくなったら、その説明こそが指示に足りていない半分だ
この落とし穴に、見事にはまりました。別の実験で、質問の書き方ひとつで結果が2/5から20/20まで動いています。3本目の記事でその話を書きます。
上限値も書いてあります。
| コンテキスト | 1リクエスト64kトークン。うち state +最長の質問で32kまで |
| レート制限 | 250,000トークン/秒、1,200リクエスト/分 |
| 入力 | テキストのみ。画像・音声・動画は不可 |
レート制限は「需要が大きく、予告なく変わりうる」と公式が明記しています。
この記事の数字は2026年9月19日時点のものです。
コストは公式の表どおりだった
先に、レスポンスの話をひとつ。返ってくるデータに金額は入っていません。
r.usage.input_tokens # 1717
r.usage.output_tokens # 出力は無料トークン数だけです。SDKの型定義にも「出力トークンは現時点では無課金」と書かれています。金額が欲しければ、自分で単価をかけます。
27問をまとめて投げたときの入力は1,717トークン。公式単価で計算すると $0.000072 です。
公式デモの表示は $0.000081。ほぼ一致しました。
▶コンソールで答え合わせした
掛け算が合っているかどうかは、管理画面で確かめられます。この記事の計測を全部終えた時点の24時間ぶんです。
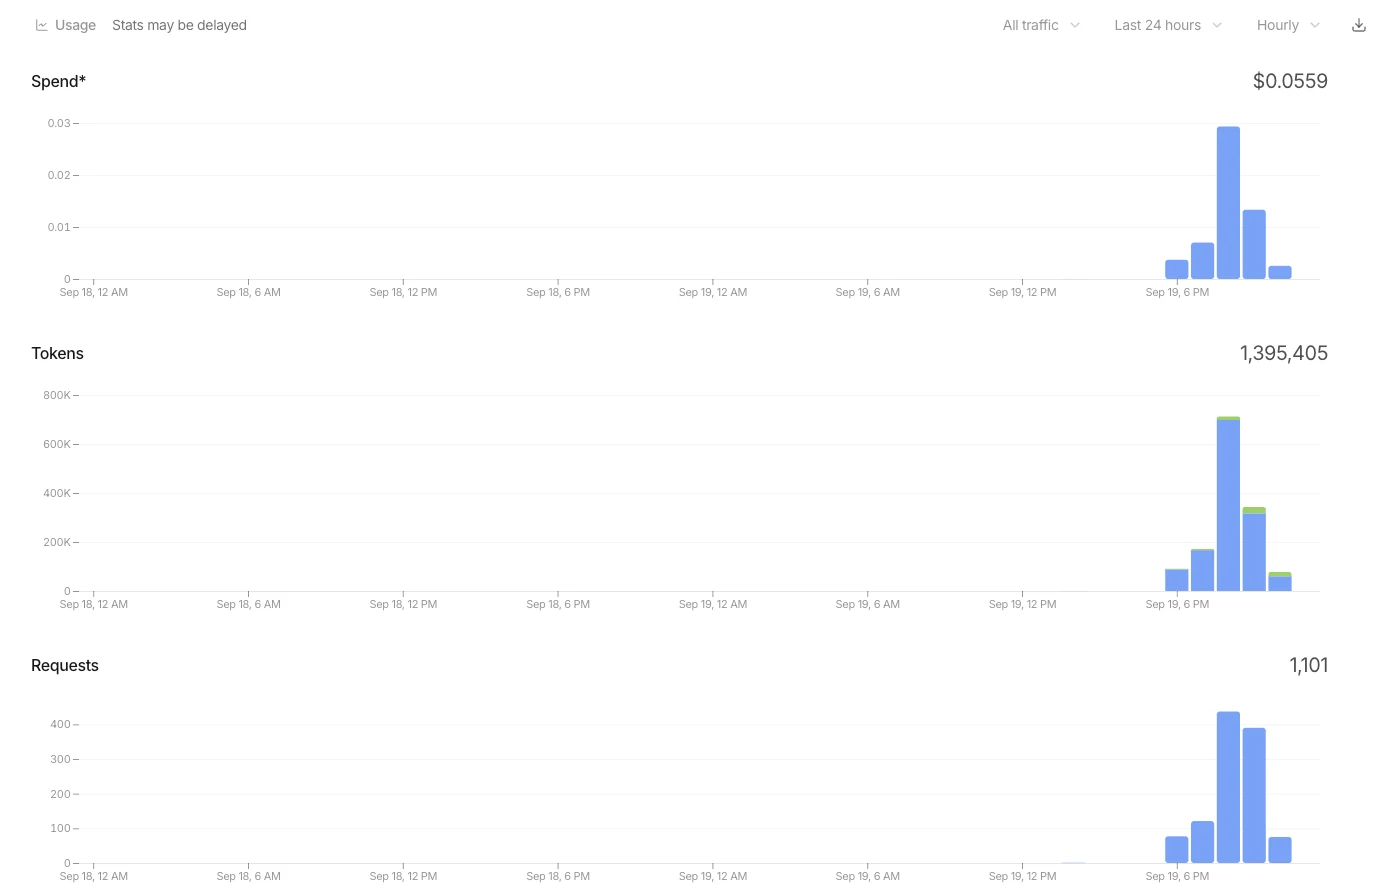
1,101リクエスト、約140万トークン、請求 $0.0559。 日本円で8円くらいです。
ここの引き算がおもしろいところでした。
| 表示されたトークン合計 | 1,395,405 |
| 全部を単価 $0.042 でかけると | $0.0586 |
| 実際の請求 | $0.0559 |
$0.0027 ぶん少ない。グラフのトークン数は入力(青)と出力(緑)の積み上げなので、無料の出力ぶんが引かれていると読めば合います。逆算すると課金対象は約133万トークン、差の6.4万トークン(4.6%)が出力ぶんです。
「出力トークンは無料」は、請求のほうでも本当でした。
管理画面には Spend* とアスタリスクが付いていて、Stats may be delayed とも出ています。
請求書そのものではないので、金額は目安として見ています。
1リクエストあたりの平均は $0.00005 でした。問い合わせ1万件に27問ずつ投げても、Jevなら0.72ドル。
この価格帯だと、気にするべきはコストより往復回数のほうでした。この話は次の記事で書きます。
まとめ
タイトルの答えから書きます。
日本語は問題ありませんでした。落ちたのは質問文の言語のほうです。
データが日本語でも、質問文が英語なら判定は 32/32 で一致しました。質問文を日本語にした瞬間に 28/32 まで落ちて、トークンも12%増えます。公式の「CJKは精度が落ちる」をデータの話だと読むと、逆をやることになります。
速度とコストは、だいたい公式の言うとおりでした。
- 大阪から p50 238ms。範囲内だが遅い側なので、日本での応答時間は自分で測ったほうがいい
- 質問を27個まとめても1.04倍。一度にたくさん聞く用途ほど効く
- 価格表は請求額でも確認できた。出力が無料なのも本当
ただし「75倍速い」は27問まとめて相手がGPT-5.6 Terraのときの数字です。相手が軽量モデルで質問1つなら4.7倍。置き換えを考えるならこちらの水準で見たほうが安全です。
そして、型安全なのは答えの「形」だけです。中身が正しいかは別の話で、そこは質問の書き方で驚くほど変わります。公式が弱点を9つ並べたページを出しているので、使う前に目を通しておくのがいいと思います。
次の記事では、この確率をどう業務の判断に落とすかを書く予定です。
使ったコード
この記事の計測に使ったコードは全部置いてあります。TYPESAFE_API_KEY を設定すればそのまま動きます。
bench.py— レイテンシ計測(質問1つ vs 3つ同時、state英語 vs 日本語)scale_check.py— 質問を1個から27個まで増やしたときのレイテンシlang_check.py— 日本語の一致検証(--jp-questionsで質問文も日本語にできます)
参考
この記事はいかがでしたか?
もしこの記事が参考になりましたら、
高評価をいただけると大変嬉しいです!
皆様からの応援が励みになります。ありがとうございます! ✨
エンジニア歴10年以上。Rust / Go / React / Python を中心にWeb開発しています。
日々の学びや技術的な知見をこのブログで発信しています。