 Techarm Blog
LayaはJevの代わりになるか。速さの対価は質問文の設計だった
前の記事の最後で、次は業務の判断の話を書くと予告していました。
https://techarm.dev/posts/typesafe-jev-japanese-latencyところが書き始めたところで、GitHubで「Jevに負けないくらいの性能」とうたうオープンソースのモデルを見つけました。Laya というモデルです。Jevと同じ使い方ができて、しかもAPIではなく手元のパソコンで動きます。
https://github.com/NandhaKishorM/laya紹介するだけでなく、自分の手元で動かして確かめたくなりました。使ったのは Mac Studio(M1 Ultra、メモリ64GB)です。業務の話は、そのあとに回します。
先に結論
1. 速い。 Layaは手元で1回の判断が10ms。JevはAPIの呼び出しに178〜238msかかるので、約18倍です。ただしJevの時間には、通信の時間も入っています。
2. でも、そのまま置き換えられるほどではない。 何を判断させるかで、結果が分かれました。
いちばん差が出たのは迷路です。迷路を通しで解かせると、Layaは47.6%、Jevは100%でした。分かれ道を1問ずつ聞いたときは、Layaも98.3%正解していたのにです。
3. 質問文の書き方で、結果が大きく変わる。 同じ判断でも、言い回しだけで12.5%から100%まで動きました。Jevは最初の書き方のままで100%です。そして、ルールの足し方を間違えると、Jevでも崩れました。
どうやって比べたか
JevとLayaに同じことを聞いて、答えを比べました。使ったのは、迷路とSnakeのゲームです。
迷路では、分かれ道に来るたびに「次はどっちへ進む?」と聞きます。下の動画は、2つの走りを同じ手数ずつ(1コマ4手)並べ直したものです。実際の時間のままだと、Layaは1秒かからずにゴールしてしまい、どう歩いたかが見えないためです。
走り終わった画面がこちらです。
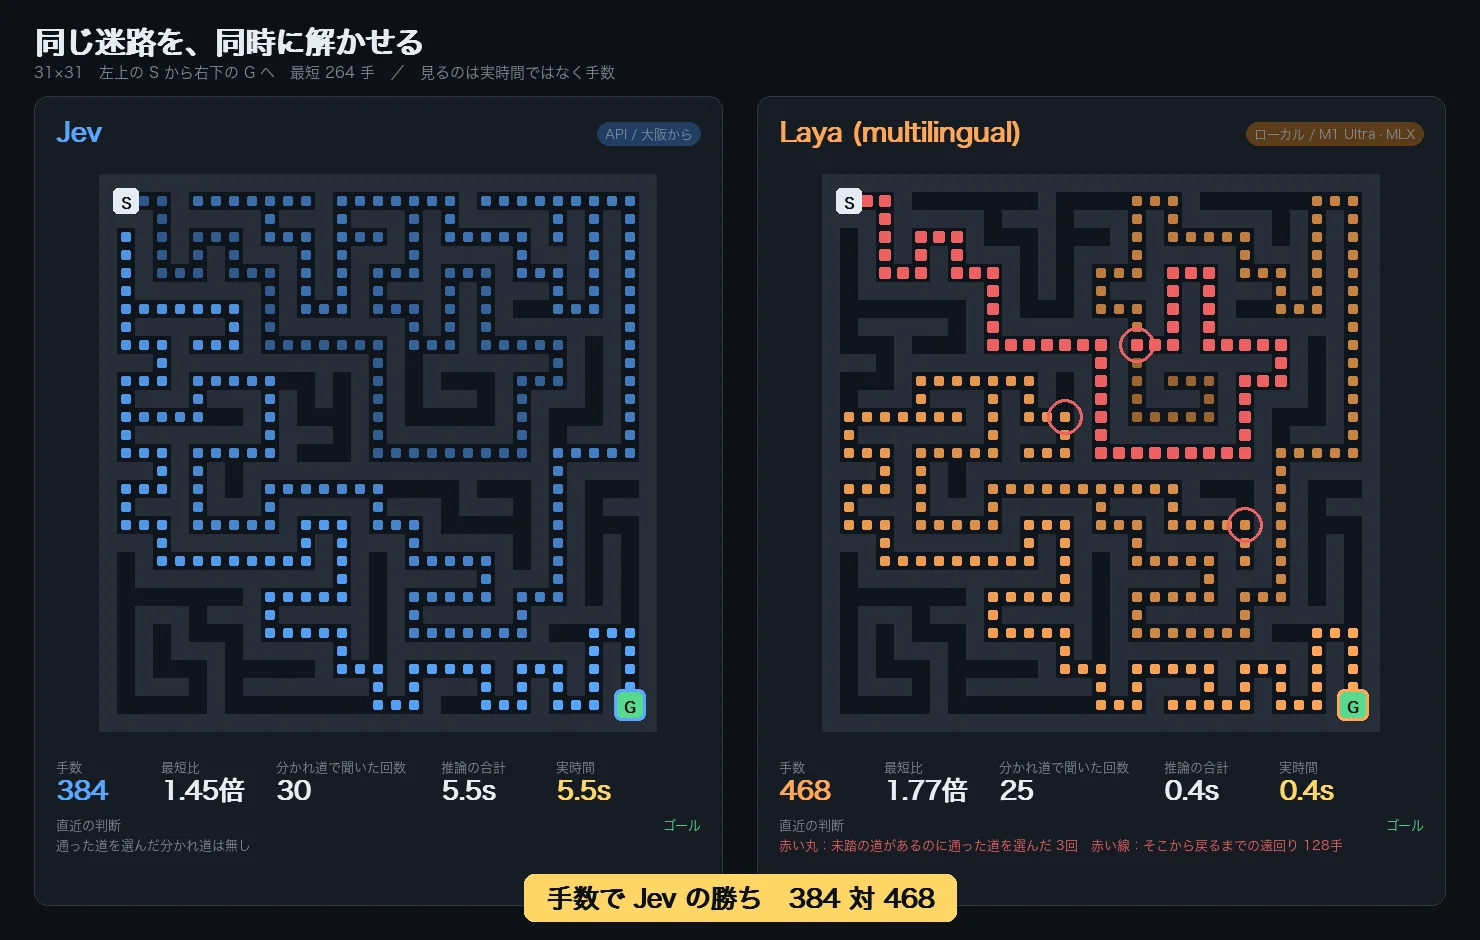
左上の S から右下の G まで、どちらもたどり着いています。手数ではJevが勝ち(384手 対 468手)、時間ではLayaが勝ち(5.5秒 対 0.4秒)。
「分かれ道で聞いた回数」は、Jevのほうが多い(30回 対 25回)のに手数は少ない、というのが不思議に見えるかもしれません。一本道ではモデルに聞かずに進むので、長い行き止まりを往復しても、この回数は増えません。
Laya側の赤い丸と赤い線は、Layaが間違えた場所です。これは迷路の節で詳しく書きます。
Jevの手数は、走るたびに変わります。同じ迷路を8回走らせると、328手が2回、384手が5回、432手が1回でした。分かれ道で、どちらも未踏のまま 0.5 対 0.5 になることがあり、どちらを引くかで道が変わるためです。Layaは8回とも468手でした。
Snakeでは、1マス進むたびに「次はどっちへ曲がる?」と聞きます。
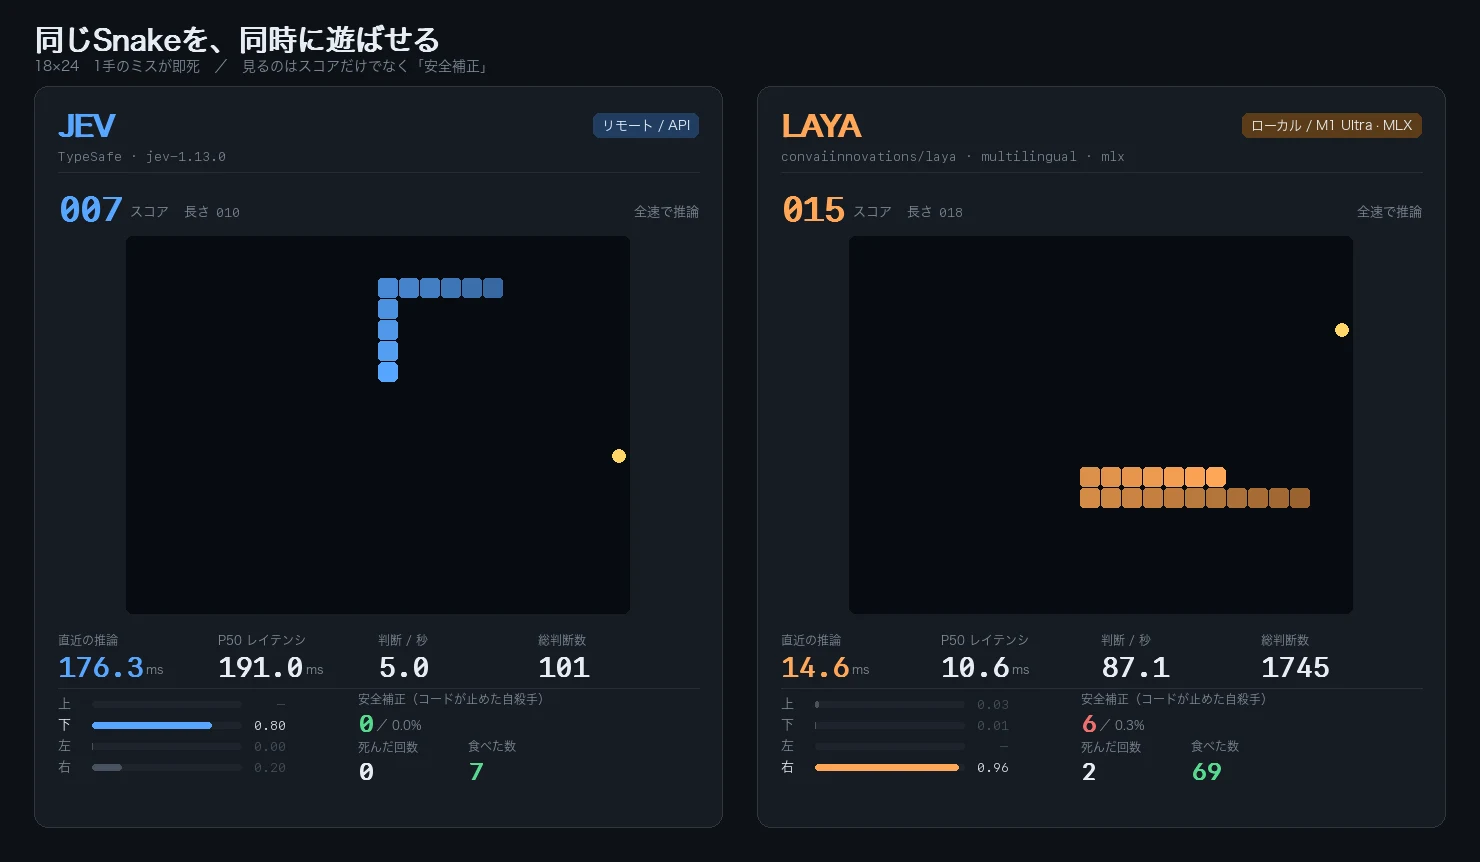
どちらも左がJev、右がLayaで、同じ盤面を同時に動かしています。パネルの下にある棒が、上下左右それぞれにモデルが付けた確率です。
Snakeには終わりが無いので、画面の点数はそのまま比べられません。同じ20秒でも、Jevは101回、Layaは1,745回判断しています。比べるときは、判断の回数をそろえて数えました。
モデルに渡すものは、どちらも2つだけです。
- 判断の材料(state) … 周りの様子。たとえば「上は壁、右はまだ行ったことがない」
- 選択肢(criteria) … 上・下・左・右のうち、進める方向
Layaだと、こんなふうに呼び出します。Snakeの例で、材料と質問文は試行錯誤の末にたどり着いた書き方です。
import laya_mlx as laya # 本家なら import laya
agent = laya.load("convaiinnovations/laya", subfolder="multilingual")
r = agent.predict(
# 判断の材料(state)
{"directions": {"up": "toward the apple", "down": "blocked", "left": "away"}},
# 質問文と選択肢(criteria)
{"direction": {
"type": "choice",
"instructions": "Which direction should the snake move next? "
"Read `directions`. Never choose blocked. "
"Choose the direction that is toward the apple.",
"criteria": {"up": "move up", "down": "move down", "left": "move left"},
}},
)
print(r["answers"]["direction"]["choice"]) # up
print(r["answers"]["direction"]["probabilities"]) # {'up': 0.962, 'down': 0.023, 'left': 0.015}Jevも同じ形で、材料と選択肢を渡すと確率が返ってきます(呼び出し方は前の記事に書きました)。
ゲームを動かしている様子は、次の記事でまとめて見せます。この記事では、どれくらい正しく選べたかを数字で比べます。
Layaってどんなモデルか
Convai Innovations が公開しているモデルで、誰でも自由に使えます(Apache-2.0)。Jevと同じく文章は書かず、質問に確率で答えます。
中身の違う版(チェックポイント)が3つあります。
| 名前 | 中身 | 一度に読める量 |
|---|---|---|
| english | ModernBERT-large 421M | 512トークン |
| multilingual | mmBERT-base 322M | 1,024トークン |
| typed-decisions | english を追加で学習させたもの | 1,024トークン |
公式は typed-decisions で「Jevの0.727に対して0.766」というベンチの数字を出しています。なので最初はこれを使いました。ところが迷路では、この版がいちばん悪く、60問中1問も正解しませんでした。理由はあとで書きます。
速さは、手短に
Layaの速さは、すでに日本語でいくつも記事が出ています。mizchi さんは MLX で3問8〜9ms、kanta13jp1 さんは9ms対317ms、GMO さんは35〜50ms対210〜240msと書いています。
https://zenn.dev/mizchi/articles/laya-mlx-60fpsなので、手元の数字だけ置いておきます。
| 1回の判断(中央値) | 条件 | |
|---|---|---|
| Jev | 178〜238ms | 大阪から API |
| Laya 本家(PyTorch) | 21.3ms | M1 Ultra の GPU |
| Laya MLX版(非公式) | 10.0ms | M1 Ultra の GPU |
MLX版は、Laya を作った人とは別の人が、Apple Silicon 向けに書き直したものです。
https://github.com/mizorewww/laya-mlx2026年9月19日に公開されたばかりで、10月1日の時点でコミットはまだ6つでした。本当に本家と同じ答えを返すのか、Snakeの場面200件で比べてみると、200件すべて同じ答えでした。確率のずれも最大0.0027。速いぶん、こちらを使って問題なさそうです。
公称値は M3 Max で7.4msです。M1 Ultra はコア数こそ多いものの10.0msで、チップの世代の差が出たようです。
設定の問題か、頭の良さの差か
最初に迷路で試したところ、Jevはゴールしたのに、Layaは同じ迷路の出口にたどり着けませんでした。
設定がおかしいのか、それとも頭の良さがそんなに違うのか。見ていて、まずそこが気になりました。
▶答えが決まっている場面だけで比べる
ゴールできたかどうかだけでは、原因が分かりません。1回曲がり損ねれば遠回りになりますし、運よく当たることもあります。
そこで「まだ行っていない道が1本だけ、残りはもう通った道」という分かれ道を60件集めました。正解は必ず、まだ行っていない道です。選択肢は2〜3つなので、でたらめに選んでも49.7%は当たります。
| 正答 | |
|---|---|
| Laya typed-decisions | 16.7% |
| Laya english | 25.0% |
| Laya multilingual | 48.3% |
| でたらめに選んだ場合 | 49.7% |
3つとも、でたらめに選ぶのと同じか、それ以下でした。
▶壊れているのか、読めていないのか
まず、入力が長すぎて途中で切れていないかを見ました。295トークンで、切れていません(上限は512〜1,024トークン)。
次に、答えの対応がずれていないか。「猫は黒い」と渡して「黒い/白い」を選ばせると、0.942の確率で「黒い」を選びます。モデルが壊れているわけでもなさそうです。
▶選択肢の説明を読んでいなかった
原因が見えたのは、選択肢の説明を入れ替えてみたときです。
「まだ行っていない」と書いた選択肢を、上と下で入れ替えました。普通なら、答えも入れ替わるはずです。
上の説明が「まだ行っていない」 → 上を選ぶ(0.594)
下の説明が「まだ行っていない」 → 上を選ぶ(0.591)答えは、ほとんど変わりません。選択肢の説明を、見ていなかったようです。
「猫は黒い」が解けたのは、材料のほうに「The cat is black」と書いてあったからでした。どうやらLayaは、材料に書いてあることと選択肢を見比べて選んでいます。だから、選択肢の説明にしか書いていないことは使われません。
迷路の作りが、まさにそうでした。「その道に行ったことがあるか」を、選択肢の説明にだけ書いていました。Jevはそれでも正しく選べていたので、気づきませんでした。
▶材料に移したら、今度は逆を選んだ
それならと、「行ったことがあるか」を材料のほうに移しました。今度は反応します。ところが、試した2問とも逆の方向を選びました。
指示: Which direction should the explorer move next? Prefer a direction that is unvisited.
材料: down: "visited 3 times"指示にある unvisited(まだ行っていない)の中に、visited(行ったことがある)がそのまま入っています。見比べて選ぶなら、visited 3 times と書かれた方向のほうが、指示に近く見えてしまいます。
書き方を変えて、また2問ずつ試しました。new / old は1問だけ正解。visits: 0 / visits: 3 と数字で書いても1問。never been there / been there 3 times にしたら、2問とも正解しました。
▶直したら、1問ずつなら98.3%になった
材料に方向ごとの事実を書き、never been there の言い回しにして、同じ60件で測り直しました。
| 正答 | 1位と2位の確率の差 | |
|---|---|---|
| Laya multilingual | 98.3% | 0.476 |
| Laya english | 48.3% | — |
| Laya typed-decisions | 0.0% | — |
| Jev | 100% | 0.988 |
multilingual は98.3%。直す前の言い回しに戻すと85.0%なので、言い回しだけで13ポイント変わっています。この時点では、設定の問題だったと思っていました。
▶でも、通しで解かせると47.6%だった
ところが、記事の最初に載せた迷路の画像では、Layaが3回間違えています。赤い丸が、まだ行っていない道があるのに、もう通った道を選んだ分かれ道です。
いちばん上の丸で通った道を選んだLayaは、そのままスタートまで引き返し、また同じ分かれ道に戻ってきました。行きに64手、帰りに64手で、合わせて128手。赤い線がその道のりです。左上のスタート付近が赤いのは、最初に通った道の上を、この引き返しがもう一度通ったからです。
60件で98.3%なら、1本の迷路で3回も外すことはまず起きません。そこで31×31の迷路を20本、最初から最後まで通しで解かせて、その途中の分かれ道で数え直しました。
| 正しく選んだ | 一度も間違えなかった迷路 | ゴール | |
|---|---|---|---|
| Laya multilingual | 49/103(47.6%) | 7/20 | 17/20 |
| Jev | 86/86(100%) | 20/20 | 19/20 |
数えたのは「まだ行っていない道と、もう通った道が混ざっている分かれ道」です。1問ずつ聞いた60件と同じ種類の場面です。
通しで解かせると、半分しか当たりませんでした。 1回間違えると見慣れない場面に入り、そこでさらに間違える。ループにはまった2本では、20回中18回、23回中18回外しています。
Jevも1本ゴールしていませんが、間違いは0回です。全部の道を通り終えたあとは「まだ行っていない方を選ぶ」という規則が何も決めてくれず、見えている11×11の範囲だけでは出口の方向が分からなかったのだと思います。
▶60件の中に、「上」が1つも無かった
1問ずつの98.3%と、通しの47.6%。この差の原因は、1問ずつ聞いた60件の集め方でした。
| 正解の向き | 1問ずつ聞いた60件 | 通しで解かせたLaya |
|---|---|---|
| 上 | 0件 | 17/69(25%) |
| 上以外(下・左・右) | 60件 | 32/34(94%) |
1問ずつ聞いた60件は、コードが「上→下→左→右」の順に、まだ行っていない道から探して集めた場面です。上から先に探すので、分かれ道に来たときには上はもう通ったあと。「上だけがまだ行っていない」という場面が、1つもできていませんでした。
そしてLayaは、正解が上のときだけ極端に外します。上以外なら94%で、1問ずつのときの98.3%とほぼ同じです。画像の赤い丸3つも、全部「上がまだ行っていない」場面でした。
98.3%は、Layaが苦手な場面を一度も聞いていない数字でした。
▶原因の一部は、ゴールの方角
なぜ上だけなのか。迷路のゴールは、いつも右下にあります。そして材料には「ゴールは右下の方」という情報も入れていました。上は、いつもゴールから遠ざかる向きです。
そこで、材料からゴールの方角を外して、同じ20本を走らせました。
| 材料 | 正しく選んだ | 上が正解のとき | ゴール |
|---|---|---|---|
| ゴールの方角あり | 47.6% | 17/69 | 17/20 |
| ゴールの方角なし | 78.1% | 24/37 | 19/20 |
47.6%から78.1%まで上がりました。ゴールの方角に引っ張られて、「まだ行っていない方を選ぶ」が負けていたわけです。ただ、上はまだ苦手で、Jevの100%には届きません。
最初の疑問「設定の問題か、頭の良さの差か」に答えると、設定の問題は大きかった。でも、それだけではなかった、です。
Jevは、ゴールの方角があってもなくても間違えませんでした。最初に見た確信の差(Jev 0.988、Laya 0.476)は、この崩れやすさの表れだったのかもしれません。
▶いちばん成績のいい版が、0問だった理由
公式のベンチでいちばん良い数字を出していた typed-decisions は、何をしても0問でした。理由は、公式のモデルカードに書いてありました。
"https://huggingface.co/convaiinnovations/layaThe base checkpoints sit below the majority-class baseline here — the capability on this benchmark comes from fine-tuning
0.766という数字は、そのベンチの練習問題で追加学習させた版のものでした。追加学習していない元の版は0.362で、いつもいちばん多い答えを返すだけ(0.461)よりも低い。
ベンチに合わせて鍛えた版を、ベンチ以外の問題に使ったので、迷路では役に立たなかった。そういうことだと思います。読み込むたびに「温度の設定値がおかしい」という警告(this checkpoint ships invalid temperatures)も出ていました。
英語版のほうがいいのでは?
次に気になったのは、ここです。迷路には日本語が出てこないのに、なぜ多言語版の multilingual を使うのか。英語版のほうが向いていそうです。
筋はそのとおりなのですが、測ると英語版は48.3%で、でたらめと変わりませんでした。英語専用で大きいほう(421M)が、多言語で小さいほう(322M)に負けています。
理由を探して、3つの仮説を試しました。
- 入力が長すぎた → どれも281トークンで、上限の内側でした
- 余計な情報に気を取られている → 1問ずつ聞いた60件で盤面の情報を外すと、英語版は少し上がる(58.3%)のに、multilingual は98.3%から48.3%に下がりました。盤面をちゃんと読んでいたのは multilingual のほうでした
- 文字の区切り方の違い → 語彙の数は5倍違いますが、迷路の1行
#####@..#.oはどちらも同じ5つに区切っていました
結局、理由は分かっていません。分かったのは、この迷路の盤面を読めたのは multilingual だけだった、ということです。
言い回しだけで正答率が変わる
迷路での言い回しの比較は2問ずつの手探りだったので、Snakeでもっと数を取りました。
林檎に近づく方向がちょうど1つある場面を、実際のプレイから80件集めます。正解はその1つ。3択なので、でたらめに選べば34.4%は当たります。
| 材料の書き方 | Laya |
|---|---|
open, closer to the apple / open, farther from the apple | 12.5% |
good / bad / deadly | 8.8% |
| 1行目の書き方のまま、盤面の大きさや頭・林檎の位置も足す | 6.2% |
toward the apple / away | 100% |
Jevは、3行目と同じ条件(Layaが6.2%だった書き方)でも、80件すべて正解でした。
迷路のことがあったので、この80件の正解の向きも確かめました。やはり偏っていて、右と上だけです。そこで上下・左右を入れ替えた場面も作って測りました。4行目の書き方なら、**どの向きでも100%**でした。Snakeの100%は、向きに助けられた数字ではありません。
1行目と4行目の違いは、言い回しだけです。実際に渡したものを並べます。
# 80件中 12.5%
state = {"directions": {
"up": "open, closer to the apple",
"down": "blocked",
"left": "open, farther from the apple",
}}
instructions = ("Read `directions`. Choose a direction that is open. "
"Among the open directions, choose the one that is closer to the apple.")
# 80件中 100%
state = {"directions": {
"up": "toward the apple",
"down": "blocked",
"left": "away",
}}
instructions = "Read `directions`. Choose the direction that is toward the apple."1行目は、正解にも不正解にも open と the apple が入っていて、見分けるための言葉が埋もれています。4行目なら、apple が出てくるのは正解の選択肢だけです。
ただ、それだけでは説明がつきません。good / bad / deadly は言葉も重なっていないし短いのに、8.8%でした。GMO さんの記事には「criteria は短く簡潔に」したほうがよかったとありますが、短くするだけでは足りないようです。なぜ good / bad がうまくいかないのかは、分かっていません。
もう1つ気になるのは、悪い書き方がどれも、でたらめ(34.4%)より低いことです。書き方が悪いと、ただ効かないのではなく、逆の方向に引っ張られるようです。
▶1つの場面だけで判断しない
失敗もひとつ書いておきます。
1行目の書き方は、最初に手で作った1つの場面で試したときは、2問とも正解でした(確率0.85)。それで直ったと思って走らせたら、実際の場面では12.5%でした。
1つの場面の結果は、たまたまだったわけです。迷路では、60件集めても同じことが起きました。数を集めても、集め方が偏っていれば騙されます。最後は、実際に動かして数えるしかありません。
ルールを足すと、Jevも崩れた
いちばん予想していなかったのが、これです。
Snakeでは、壁や自分の体にぶつかる方向を材料に blocked と書き、指示に Never choose blocked.(blocked は選ぶな)と入れています。ぶつかる方向が必ずある場面120件で、Layaが blocked を選んだのは0件でした。この一文を外すと、5.0%選びます。
次に、自分で自分を閉じ込めてしまう「詰み」を減らそうとしました。進むと狭い場所に入り込んで抜けられなくなる方向を材料に trap と書き、指示に一文足します。
"Read `directions`. Never choose blocked. Choose the direction that is toward the apple."
"Read `directions`. Never choose blocked. Never choose trap. Choose the direction that is toward the apple."変えたのはこれだけです。
Jevにも同じものを渡して、1,000回の判断あたりで比べたのが下の表です。「即死の手」は、blocked の方向を選んでしまった割合です。trap の方向はすぐには死なないので、ここには入れていません。
| 食べた林檎 | 即死の手を選んだ割合 | |
|---|---|---|
| Jev(足す前) | 64.1 | 0.0% |
Jev(Never choose trap. を足す) | 49.0 | 2.3% |
| Laya(足す前) | 39.5 | 0.4% |
Laya(Never choose trap. を足す) | 33.0 | 2.2% |
禁止をもう1つ足したら、もとからあった禁止が守られなくなりました。しかもJevとLayaで、ほぼ同じくらい崩れています。Jevは、足す前は0.0%でした。
trap という新しい言葉を使わずに、狭い方向も blocked と書くようにすると、Jevの即死の手は0.3%で済みました。言葉を増やさないほうが崩れにくい、とは言えそうです。
Layaのくせを調べていたつもりが、Jevにも当てはまる話になりました。お金を払ってJevを使っていても、指示を足したら、足す前と後で測ったほうがよさそうです。
ちなみに詰みは1,000回の判断で1〜2回しか起きないので、この情報は結局使いませんでした。
日本語の差は埋まらなかった
最後に、前の記事の予告に戻ります。
前の記事では、同じ内容の問い合わせを英語と日本語で16組つくり、同じ質問を投げました。Jevは、データが日本語でも英語と同じ判定を返しました(16組中16組)。そろわなくなったのは、質問文まで日本語にしたとき(16組中14組)です。
同じ16組を、Layaに投げてみました。
| 質問文が英語 | 質問文が日本語 | 同じ入力でJevと同じ答え | |
|---|---|---|---|
| Jev | 16/16 | 14/16 | — |
| Laya multilingual | 9/16 | 7/16 | 19/32 |
| Laya english | 8/16 | 12/16 | 13〜15/32 |
| Laya typed-decisions | 8/16 | 12/16 | 16〜19/32 |
Layaのいちばん良い条件でも、Jevのいちばん悪い条件に届きません。同じ入力に対してJevと同じ答えを返すのも、半分くらいです。
書き方も工夫してみました。分類の選択肢のうち、personal(個人的な連絡)の説明が "A personal message, not a support request" と否定の形になっていたので、否定を外した版でも測りました。結果は、良くなる条件と悪くなる条件が混ざって、効果はありませんでした。
これは自分だけの結果ではありません。snsk さんが日本語の業務判断40問で比べたものでは、Jev 97.6 に対して Laya 36.9。英語で比べた Hugging Face の議論でも、6択の分類で Jev 0.975 に対して Laya 0.725 でした。
https://github.com/snsk/jev-laya-japanese-business-benchmarkSnakeとの違いは、答えがどこにあるかだと思います。Snakeの「林檎に近づくか」は、材料に言葉で書いてあります。見比べれば答えが出ます。問い合わせの分類は、文章を読んで意味をつかまないと答えが出ません。こちらは、書き方では埋まりませんでした。
ついでに分かったことがもう1つあります。Layaは日本語を、言語として判定していませんでした。英語の文には language: 'en' と返しますが、日本語の文には language: None(文字の種類は、かなと判定)でした。
まとめ
LayaはJevの代わりになるか。場面による、が答えです。
- 速さは本物。 手元で10ms。APIを呼び出すJev(通信込み)の約18倍
- Snakeでは並んだ。 質問文を直せば、Jevと同じ100%
- 迷路では並ばなかった。 通しで解かせるとLaya 47.6%、Jev 100%。1問ずつならLayaも98.3%だった
- 問い合わせの分類は埋まらない。 日本語でも英語でも、Jevと半分しか一致しない
- 書き方で結果が大きく変わる。 言い回しだけで12.5%から100%まで動いた
- ルールの足し方で、Jevも崩れる。 1つ足したら、もとのルールが破られ始めた
Layaを使うなら、気をつけたいことは3つです。
- 判断に必要な事実は、材料に言葉で書く
- 試すときは、実際の使い方と同じように通しで動かして数える。1問ずつの結果は当てにならないことがある
- ルールを足したら、足す前と後で比べる。これはJevでも同じ
自分なら、ゲームや画面の操作のように、短い間隔で何度も判断するものはLayaに任せます。文章を読んで分類するような、間違えると困る判断はJevです。
前の記事で、速さは今までできなかったことを可能にする、と書きました。手元で10msのLayaは、まさにそういう使い方に向いていると思います。
先送りにした業務の判断の話は、次の記事で書きます。
使ったコード
この記事の計測に使ったコードは、全部置いてあります。Layaは初回に重み(600〜800MB)を自動でダウンロードします。Jevを使う部分は TYPESAFE_API_KEY が必要です。
diagnose.py… 迷路の分かれ道を1問ずつ聞く(60件)race_stats.py… 迷路を20本、通しで解かせて数えるdiagnose_snake.py… Snakeの言い回しの比較(80件)blocked_check.py… Snakeで、ぶつかる方向を選ぶか(120件)pocket.py…Never choose trap.を足す前と後の比較mlx_check.py… MLX版が本家と同じ答えを返すか(200件)lang_compare.py… 前の記事と同じ16組での日本語の一致率
どのスクリプトが記事のどの数字に対応するかは、リポジトリの README にまとめてあります。
参考
- convaiinnovations/laya — 公式モデルカード(typed-decisions の追加学習と弱点の記載)
- NandhaKishorM/laya — GitHub
- mizorewww/laya-mlx — 非公式のMLX移植
- Jev クローンの Laya をローカルで60fpsで動かせるか?(mizchi)
- LayaはJevより速い?ローカル判定AIの比較条件と、日本語アプリへの導入手順(kanta13jp1)
- Jevのオープンソース版「Laya」を使ってみた(GMO研究開発本部)
- 実務判断ベンチマークJP(snsk)
- Independent Laya vs Jev head-to-head on identical inputs(Hugging Face)
この記事はいかがでしたか?
もしこの記事が参考になりましたら、
高評価をいただけると大変嬉しいです!
皆様からの応援が励みになります。ありがとうございます! ✨
エンジニア歴10年以上。Rust / Go / React / Python を中心にWeb開発しています。
日々の学びや技術的な知見をこのブログで発信しています。